
O que é Data Scraping? Guia Completo com Ferramentas e Proteção
Take a Quick Look
Aprenda o que é data scraping, como funciona, técnicas comuns, usos legítimos, riscos e como proteger seus dados. Veja como o AdsPower simplifica scraping em larga escala.
🔥 Limited-Time Offer! Save extra 10% off on your first monthly plan with code: Anitdetect10
Sign upO que é Data Scraping? Guia Completo com Ferramentas e Proteção
Data scraping — frequentemente chamado de web scraping — é o processo automatizado de extrair informações de sites e transformá-las em um formato estruturado e legível por humanos, como uma planilha ou banco de dados. Seja você um profissional de marketing coletando preços de concorrentes, um jornalista analisando registros públicos ou um desenvolvedor construindo um catálogo de produtos, o data scraping economiza milhares de horas de cópia e colagem manuais. Na AdsPower, detalhamos tudo o que você precisa saber sobre essa técnica poderosa, incluindo como usá-la de forma responsável e como navegadores modernos anti-detecção como o AdsPower ajudam você a escalar sem ser bloqueado.
O que é Data Scraping? Definição e Conceitos-chave
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
Data scraping é o uso de software para extrair conteúdo de páginas web automaticamente. Em vez de clicar página após página, um scraper envia requisições HTTP, lê a resposta e extrai pontos de dados específicos — texto, imagens, preços, e-mails — para um formato estruturado. Existem três tipos principais:
- Mineração de relatórios: Extrai dados diretamente em relatórios amigáveis, quase como imprimir uma página, mas em um layout personalizado.
- Screen scraping: Extrai dados de telas de sistemas legados para que aplicações antigas possam se comunicar com interfaces modernas.
- Web scraping: O tipo mais comum, onde uma ferramenta rastreia sites e extrai dados alvo em planilhas, JSON ou bancos de dados.
As pessoas frequentemente confundem data scraping com rastreamento web (web crawling). Um rastreador (como o Googlebot) navega por toda a web, seguindo links e indexando o conteúdo das páginas principalmente lendo o código. Um scraper, por outro lado, ignora a maior parte do código e foca nos dados visíveis que você deseja — preços, manchetes, detalhes de contato — até ignorando solicitações robots.txt em alguns casos. Essa eficácia também faz do scraping um assunto frequente de uso indevido.
Como o Data Scraping Funciona?
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
A maioria dos scrapers web modernos segue um ciclo simples de três etapas:
- Requisição: O scraper envia uma requisição HTTP GET para a URL alvo, exatamente como um navegador faria.
- Análise: O HTML da resposta é analisado — seja através da árvore DOM (Modelo de Objeto de Documento), XPath ou expressões regulares — para localizar os dados exatos que você identificou.
- Extração e armazenamento: Os dados analisados fluem para um CSV, JSON, banco de dados ou planilha na nuvem para análise.
Para páginas dinâmicas que carregam conteúdo via JavaScript, os scrapers podem incorporar um navegador headless (como Puppeteer ou Playwright) para renderizar a página completamente antes da extração. Essa abordagem torna o scraper indistinguível de um visitante normal — desde que a impressão digital do navegador não o denuncie.
Técnicas e Ferramentas Comuns de Data Scraping
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
Os scrapers vêm em todas as formas, desde extensões de navegador com um clique até scripts Python personalizados. As principais técnicas incluem:
- Análise de HTML: Usar uma biblioteca como BeautifulSoup (Python) para analisar HTML estático e extrair links, tabelas ou texto.
- Análise do DOM: Navegar pela árvore DOM ativa com JavaScript no console do navegador ou através de ferramentas como Cheerio.
- Seletores XPath / CSS: Linguagens precisas de seleção de nós que permitem que scrapers identifiquem elementos mesmo quando a estrutura da página muda.
- Plataformas de agregação vertical: Bots baseados em nuvem que visam indústrias específicas — pense em agregadores de tarifas de viagem ou coletores de quadros de empregos — com intervenção humana mínima.
- Google Planilhas: As funções
IMPORTXML,IMPORTHTMLeREGEXEXTRACTpermitem que qualquer pessoa extraia dados de uma URL diretamente para uma planilha sem programação.
Ferramentas dedicadas como Scrapingdog (uma API totalmente gerenciada), extensões de navegador como Data Scraper ou Data Miner, e frameworks de automação como Selenium, Puppeteer e Playwright dão aos desenvolvedores controle total. Para uma comparação direta das principais bibliotecas, veja nosso guia Top 10 Bibliotecas de Automação de Navegador em 2026.
Usos Legítimos do Data Scraping
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
Quando usado eticamente, o data scraping alimenta indústrias inteiras. Casos de uso legítimos comuns:
- Pesquisa de mercado e análise competitiva: Acompanhamento de preços de concorrentes, catálogos de produtos e sentimento do cliente a partir de páginas públicas.
- Geração de leads: Compilação de dados de contato de negócios publicamente disponíveis para prospecção de vendas.
- E-commerce e marketing de afiliados: Alimentação de feeds de produtos para o Google Shopping ou agregação de ofertas de várias lojas.
- Projetos acadêmicos e jornalísticos: Coleta de conjuntos de dados públicos para análise; por exemplo, a famosa comparação do BuzzFeed de todos os discursos do Estado da União dependeu de transcrições extraídas.
- Monitoramento financeiro e imobiliário: Agregação de tickers de ações, listagens de imóveis ou indicadores econômicos.
Todas essas atividades pressupõem que o scraper respeite os termos de serviço da fonte, limites de taxa e regulamentações de privacidade como GDPR ou CCPA.
Riscos do Data Scraping e Preocupações Éticas
Atores mal-intencionados abusam da mesma tecnologia para:
- Coletar endereços de e-mail e dados pessoais para ataques de spam ou phishing.
- Roubar conteúdo protegido por direitos autorais e republicá-lo sem permissão.
- Realizar credential stuffing ou engenharia social usando detalhes de funcionários extraídos.
- Prejudicar modelos de negócios subcotando preços sistematicamente ou sobrecarregando servidores.
Casos de alto perfil, como o Facebook processando empresas em 2020 por scraping de dados de usuários através de extensões maliciosas, mostram como o scraping pode passar de ferramenta a arma. A legalidade também varia: algumas jurisdições proíbem completamente a coleta automatizada de e-mails, e o scraping atrás de uma barreira de login quase sempre viola o Computer Fraud and Abuse Act nos EUA.
Como Proteger Seus Dados contra Scraping
Como qualquer dado visível a um usuário também é visível a um scraper, nenhuma defesa é perfeita. No entanto, essas quatro camadas elevam significativamente a barreira:
- Limitação de taxa: Limitar requisições de um único endereço IP para que ninguém possa extrair todo o seu site em segundos. Ferramentas modernas como Imperva oferecem proteção avançada contra bots para impor esses limites dinamicamente.
- Desafios CAPTCHA: Forçar visitantes de alto volume a provar que são humanos. Embora não seja infalível, os CAPTCHAs interrompem fluxos de trabalho automatizados.
- Alterações frequentes na marcação HTML: Randomizar classes CSS, aninhar elementos ou alterar a estrutura do DOM a cada renderização. Um scraper que depende de seletores fixos quebrará.
- Incorporar dados sensíveis em imagens: Preços, números de telefone e endereços de e-mail renderizados como imagens exigem OCR para extração, adicionando atrito sem prejudicar a experiência genuína do usuário.
Para proteção de nível empresarial, soluções como a Proteção Avançada contra Bots da Imperva combinam aprendizado de máquina, análise comportamental e mecanismos de desafio-resposta para bloquear scrapers antes mesmo de se conectarem.
Scraping em Escala: Gerenciando Impressões Digitais e Proxies
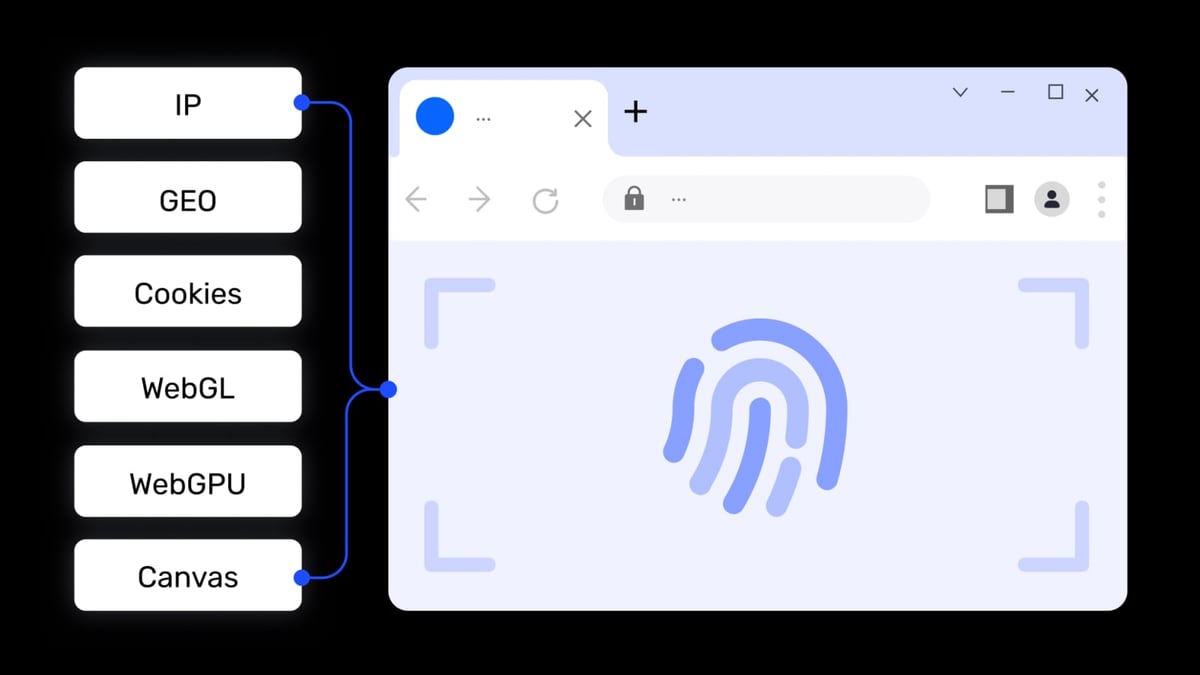
Quando você vai além de uma única extração de planilha e começa a fazer scraping em larga escala, rapidamente encontra um obstáculo: os sites ativamente identificam a impressão digital do seu navegador para detectar automação. Eles verificam hashes de Canvas, strings do renderizador WebGL, processamento de áudio e até sua lista de fontes. Se cem requisições vierem da mesma impressão digital, o IP é bloqueado — ou pior, o alvo introduz um banimento persistente.
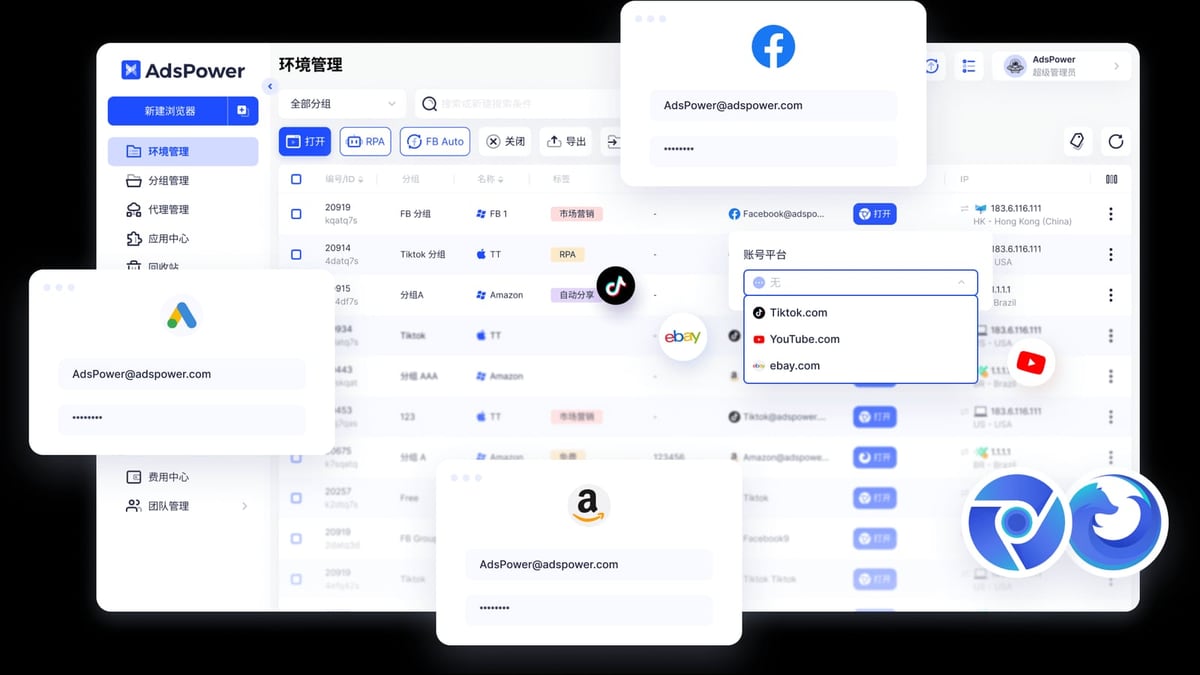
É aí que um navegador anti-detecção se torna essencial. AdsPower é um navegador profissional de impressão digital que cria ambientes de navegador isolados, cada um com uma identidade digital única e persistente. Você pode personalizar mais de 20 parâmetros de impressão digital (Canvas, WebGL, AudioContext, WebRTC) para que cada perfil de scraper pareça um usuário real distinto em um dispositivo diferente. Para equipes de data scraping, o AdsPower oferece:
- Múltiplos kernels de navegador: SunBrowser baseado em Chromium e FlowerBrowser baseado em Firefox para imitar diversos ambientes de cliente.
- Integração de proxy: Suporte nativo para proxies HTTP, HTTPS, SOCKS5 e SSH com cobertura global de IP, permitindo que você associe cada perfil de navegador a um IP residencial ou de datacenter.
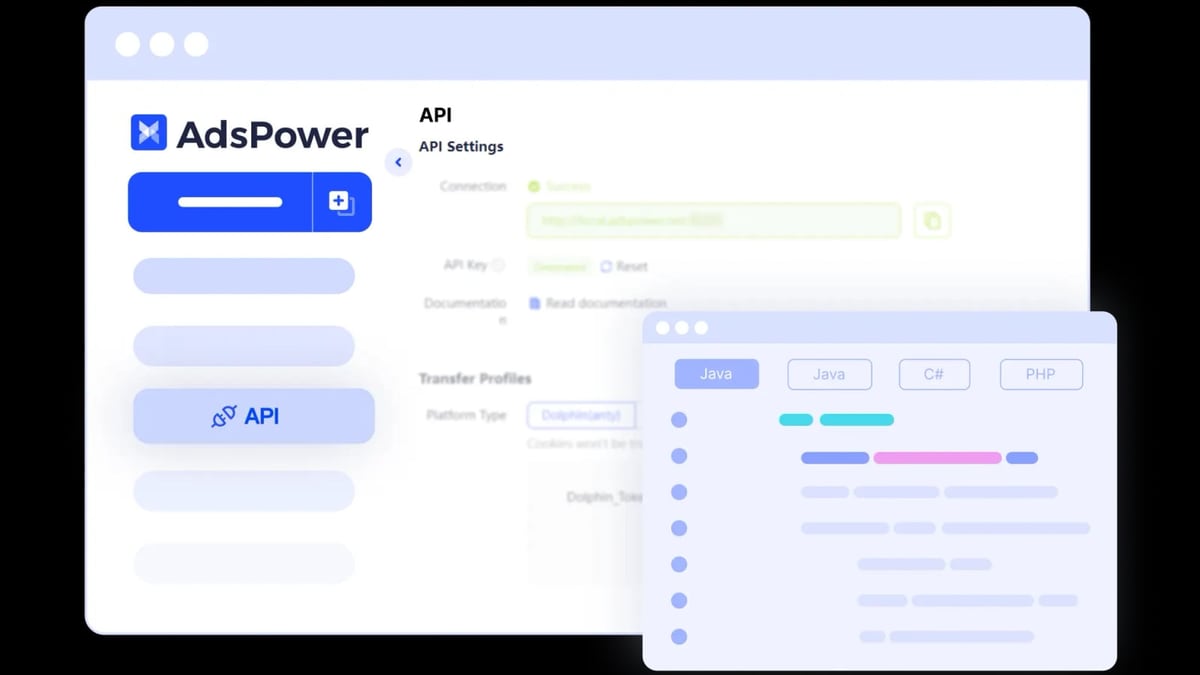
- APIs de automação: Uma API local compatível com Selenium, Puppeteer, Playwright e até o protocolo MCP para fluxos de trabalho de agentes de IA. Você pode controlar os ambientes do navegador programaticamente enquanto mantém as impressões digitais consistentes.
- Modelos RPA: Robôs integrados e sem código que automatizam operações repetitivas de scraping sem escrever um script.
Ao combinar o AdsPower com uma rede de proxies confiável, você reduz o risco de detecção para quase zero. Para uma comparação detalhada de navegadores anti-detecção, leia nossa Comparação AdsPower vs RoxyBrowser vs Kameleo.
Leitura relacionada
- Análise do Scrapingdog: API de Web Scraping Confiável para Desenvolvedores? - Análise aprofundada do Scrapingdog cobrindo testes de velocidade, preços, APIs dedicadas, configuração e casos de uso ideais para equipes de SEO, e-commerce e IA.
Fontes e leitura adicional
- [ELI5] O que é data scraping e por que é ruim? - Resultados da web[ELI5] O que é data scraping e por que é ruim?Reddit · r/explainlikeimfive9 comentários · 3 anos atrásReddit · r/explainlikeimfive9 comentários · 3 anos atrásData scraping é simplesmente encontrar dados - não importa o que seja - na internet destinados ao consumo humano, mas tendo um bot (ou seja, então
- O que é Data Scraping? Definição e Uso - Data scraping envolve extrair informações de um site para uma planilha. Para um coletor de dados dedicado, o método é uma forma eficiente de obter uma grande quantidade de informações para análise, processamento ou apresentação.
- O que é Data Scraping | Técnicas, Ferramentas e Mitigação | Imperva - Data scraping usa um código de software para extrair dados de sites. O software de data scraping pode ser usado tanto de forma legítima quanto ilegal.
Perguntas Frequentes
O data scraping é legal?
Geralmente, extrair dados publicamente acessíveis que não exigem login é legal em muitos países, desde que você respeite direitos autorais, termos de serviço e leis de proteção de dados. Sempre consulte um profissional jurídico para o seu caso específico.
Qual é a diferença entre web scraping e data scraping?
Web scraping é um subconjunto do data scraping que se concentra exclusivamente em sites. Data scraping também pode envolver telas de sistemas legados, PDFs ou outras fontes digitais.
Posso fazer scraping de um site sem programar?
Sim. Extensões de navegador como Data Miner e funções internas do Google Planilhas (IMPORTXML) permitem que não programadores extraiam dados facilmente. Para necessidades avançadas, plataformas sem código e ferramentas RPA dentro do AdsPower simplificam o processo.
Como evitar ser bloqueado durante o scraping?
Rotacione IPs usando proxies, espaçe as requisições, randomize strings de user-agent e use um navegador anti-detecção como o AdsPower para manter impressões digitais únicas. Além disso, respeite o robots.txt e implemente atrasos educados.
Quais são os melhores proxies para data scraping?
Proxies residenciais e de ISP oferecem a maior confiança. Para casos de uso de multi-contas e scraping, confira nossa Análise do Proxy-Seller para uma visão honesta do desempenho no mundo real.
Conclusão: Data Scraping Feito da Forma Correta
Data scraping é uma faca de dois gumes. Nas mãos certas, ele impulsiona pesquisa, automação e inteligência competitiva. Nas erradas, invade a privacidade e rouba conteúdo. A chave é usar as ferramentas certas, respeitar limites e proteger seus próprios ativos contra abusos. Quer você esteja começando com o Google Planilhas ou projetando um pipeline de scraping de alto volume, entender as técnicas principais — e as defesas em nível de impressão digital contra detecção — é essencial. Para comparações mais aprofundadas, análises e estratégias de automação, explore os recursos aqui na AdsPower.