
AdsPower + Beautiful Soup: Guia de Web Scraping 2026
Uma olhada rápida
Aprenda a combinar o navegador anti-detecção AdsPower com Beautiful Soup para web scraping anônimo e escalável. Configuração passo a passo, exemplos de código e casos de uso.
AdsPower + Beautiful Soup: A Combinação Definitiva para Web Scraping em 2026
O web scraping é essencial para pesquisa de mercado, monitoramento de preços e geração de leads. Mas os sites modernos contra-atacam com bloqueios de IP, CAPTCHAs e impressão digital do navegador. É aí que entram o AdsPower (um navegador anti-detecção profissional) e o Beautiful Soup (uma biblioteca Python de análise de HTML). Este guia mostra como combinar essas ferramentas para fluxos de trabalho de scraping anônimos, escaláveis e sustentáveis.
Por que Combinar AdsPower com Beautiful Soup?
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
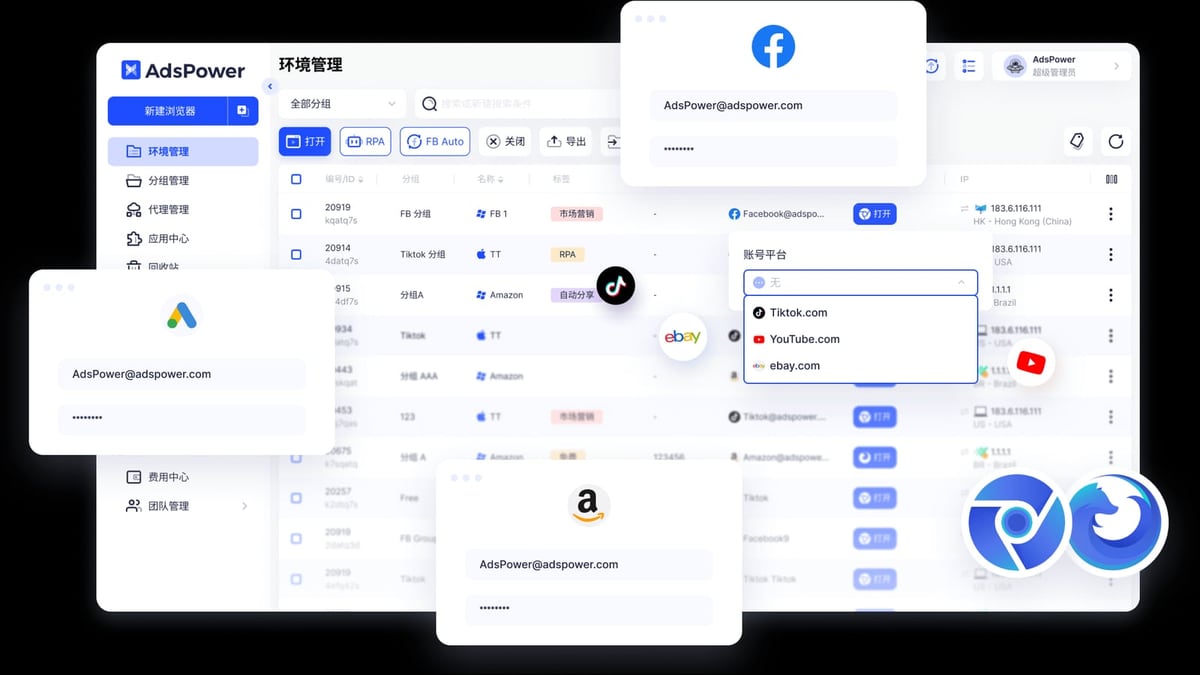
O AdsPower cria ambientes de navegador isolados com impressões digitais digitais únicas. Ele permite gerenciar várias contas ou sessões de scraping sem ser detectado. O Beautiful Soup, por outro lado, é a biblioteca Python preferida para extrair dados estruturados de HTML e XML. Juntos, eles resolvem dois problemas centrais:
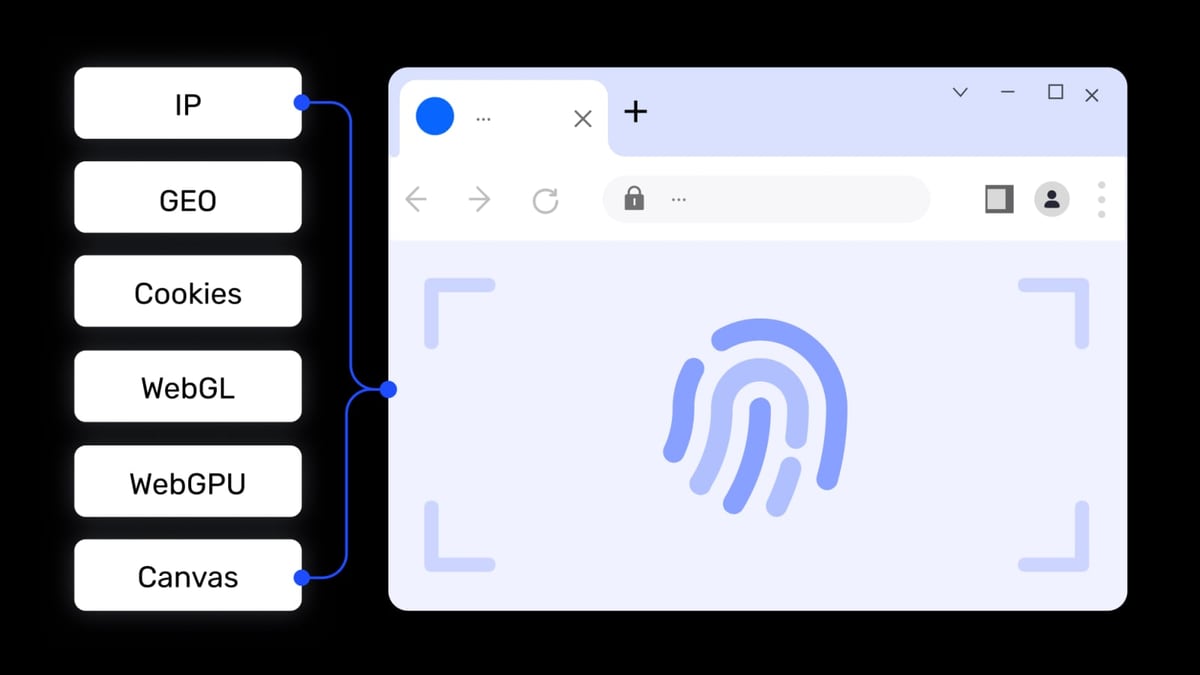
- Evitar detecção: O AdsPower falsifica Canvas, WebGL, Audio, WebRTC e mais de 20 outros parâmetros de impressão digital, fazendo cada sessão parecer um usuário real em um dispositivo diferente.
- Análise eficiente: O Beautiful Soup transforma HTML bagunçado em uma árvore navegável, permitindo extrair exatamente o que você precisa com código mínimo.
Essa combinação é ideal para vendedores de comércio eletrônico transfronteiriço, profissionais de marketing de afiliados e analistas de dados que precisam raspar plataformas como Amazon, Facebook ou Google sem acionar bloqueios.
Como o Fluxo de Trabalho Funciona
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
- Configure um ambiente de navegador AdsPower com um proxy e impressão digital personalizada.
- Use a API Local do AdsPower para iniciar esse ambiente programaticamente a partir do Python.
- Navegue até a URL alvo usando Selenium ou Playwright dentro da janela do AdsPower.
- Passe o código-fonte da página para o Beautiful Soup para análise e extração de dados.
- Repita em vários ambientes para escalar o scraping sem riscos de associação.
Guia de Configuração Passo a Passo
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
Pré-requisitos
- AdsPower instalado (a versão gratuita inclui 2 ambientes de navegador).
- Python 3.7+ com
requests,beautifulsoup4eseleniuminstalados. - API Local do AdsPower ativada (Configurações > Configurações da API > Ativar API Local).
Passo 1: Criar um Ambiente de Navegador no AdsPower
Abra o AdsPower e clique em Novo Navegador. Configure:
- Nome do Navegador: por exemplo, "Scraper-01"
- Impressão Digital: Escolha um SO, resolução e fuso horário realistas.
- Proxy: Adicione um proxy confiável (HTTP/HTTPS/SOCKS5). O AdsPower suporta entrada de proxy personalizada.
- Plataforma: Selecione o site alvo (opcional, para otimização da impressão digital).
Após a criação, anote o ID do Ambiente (uma string hexadecimal de 32 caracteres) – você precisará dele para a API.
Passo 2: Iniciar o Ambiente via API do AdsPower
O AdsPower fornece uma API REST para abrir janelas do navegador. Use este script Python para iniciar um ambiente:
import requests
import json

# Endpoint da API Local do AdsPower
url = "http://local.adspower.net:50325/api/v1/browser/start"

# Seu ID de ambiente
env_id = "SEU_ID_DE_AMBIENTE"

params = {
    "user_id": env_id,
    "open_urls": "https://example.com"  # opcional
}

response = requests.get(url, params=params)
data = response.json()

if data["code"] == 0:
    print("Navegador iniciado com sucesso")
    print("URL do depurador WebSocket:", data["data"]["ws"]["selenium"])
else:
    print("Erro:", data["msg"])
Passo 3: Conectar o Selenium à Janela do AdsPower
O AdsPower retorna uma URL do depurador WebSocket que você pode usar com o driver Remote do Selenium:
from selenium import webdriver
from selenium.webdriver.chrome.options import Options

chrome_options = Options()
chrome_options.add_experimental_option("debuggerAddress", "127.0.0.1:9222")  # porta da resposta da API

driver = webdriver.Chrome(options=chrome_options)
driver.get("https://example.com")
Nota: A porta exata é fornecida na resposta da API em
data.data.ws.selenium. Pode ser necessário analisá-la.
Passo 4: Extrair o Código-Fonte da Página e Analisar com Beautiful Soup
Assim que a página carregar, pegue o HTML e deixe o Beautiful Soup fazer sua mágica:
from bs4 import BeautifulSoup

html = driver.page_source
soup = BeautifulSoup(html, "html.parser")

# Exemplo: extrair todos os títulos de produtos
titles = soup.find_all("h2", class_="product-title")
for title in titles:
    print(title.get_text(strip=True))
Passo 5: Fechar o Ambiente
Sempre feche o navegador para liberar recursos:
requests.get("http://local.adspower.net:50325/api/v1/browser/stop", params={"user_id": env_id})
Exemplo Prático: Raspagem de Preços de Produtos
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
Digamos que você queira monitorar preços em um site de comércio eletrônico. Aqui está um script completo que usa o AdsPower para anonimato e o Beautiful Soup para análise:
import requests
from selenium import webdriver
from bs4 import BeautifulSoup

# Iniciar ambiente AdsPower
env_id = "abc123..."
start_resp = requests.get("http://local.adspower.net:50325/api/v1/browser/start",
                          params={"user_id": env_id, "open_urls": "https://shop.example.com/products"})
data = start_resp.json()

# Conectar Selenium
debugger_url = data["data"]["ws"]["selenium"]
chrome_options = webdriver.ChromeOptions()
chrome_options.add_experimental_option("debuggerAddress", debugger_url.split(":")[-1])
driver = webdriver.Chrome(options=chrome_options)

# Aguardar carregamento da página (use esperas explícitas em produção)
import time
time.sleep(3)

# Analisar com Beautiful Soup
soup = BeautifulSoup(driver.page_source, "html.parser")
prices = []
for item in soup.select(".product-card"):
    name = item.find("h3").get_text(strip=True)
    price = item.find("span", class_="price").get_text(strip=True)
    prices.append({"name": name, "price": price})

print(prices)

# Limpeza
driver.quit()
requests.get("http://local.adspower.net:50325/api/v1/browser/stop", params={"user_id": env_id})
Escalando com Múltiplos Ambientes
O AdsPower permite criar centenas de ambientes, cada um com uma impressão digital e proxy únicos. Para raspar em escala:
- Crie um CSV com IDs de ambiente, proxies e URLs alvo.
- Use threading ou asyncio para iniciar vários ambientes simultaneamente.
- Rotacione as impressões digitais para evitar detecção de padrões.
Exemplo de trecho usando concurrent.futures:
from concurrent.futures import ThreadPoolExecutor

def scrape_env(env_id, proxy, url):
    # Iniciar, raspar, analisar, fechar
    pass

with ThreadPoolExecutor(max_workers=5) as executor:
    executor.map(scrape_env, env_ids, proxies, urls)
Problemas Comuns e Soluções
| Problema | Solução |
|---|---|
| A API do AdsPower retorna "porta já em uso" | Feche ambientes não utilizados ou aumente o intervalo de portas nas configurações do AdsPower. |
| Beautiful Soup não encontra elementos | Verifique se o conteúdo é carregado via JavaScript. Use WebDriverWait do Selenium antes de analisar. |
| Sites ainda bloqueiam requisições | Certifique-se de que seu proxy está limpo e não está na lista negra. Considere rotacionar proxies por ambiente. |
| Incompatibilidade de versão do driver Selenium | Corresponda a versão do ChromeDriver à versão do Chromium usada pelo AdsPower (SunBrowser). |
Leitura Relacionada
- AdsPower vs MuLogin: Qual Navegador Anti-Detecção Vence em 2026? - Compare os navegadores anti-detecção AdsPower e MuLogin para gerenciamento de múltiplas contas. Veja recursos, preços, automação e qual ferramenta se adequa ao seu fluxo de trabalho.
- Revisão do AirdropAlert 2026: É o Melhor Agregador de Airdrops? - Revisão honesta do AirdropAlert cobrindo recursos, preços, feedback de usuários e configuração. Veja se este agregador de airdrops se adequa à sua estratégia de farming.
- Top 10 Plataformas de Dados do Mercado de Criptomoedas 2026 - Descubra as 10 melhores plataformas de dados do mercado de criptomoedas para 2026. Lista classificada por especialistas com preços em tempo real, análises on-chain, APIs e muito mais.
FAQ
Posso usar Beautiful Soup sem Selenium no AdsPower?
Sim, se a página alvo for estática. Você pode usar requests dentro do ambiente AdsPower configurando o mesmo proxy e user-agent. No entanto, a maioria dos sites modernos requer renderização JavaScript, então o Selenium é recomendado.
O plano gratuito do AdsPower é suficiente para scraping?
O plano gratuito inclui 2 ambientes de navegador. Para scraping em pequena escala, é suficiente. Para projetos maiores, considere um plano pago que suporte mais ambientes e colaboração em equipe.
Isso funciona com Playwright ou Puppeteer?
Com certeza. A API Local do AdsPower também retorna URLs WebSocket compatíveis com Playwright e Puppeteer. A mesma lógica do Beautiful Soup se aplica.
Como lidar com CAPTCHAs?
O isolamento de impressão digital do AdsPower reduz os acionamentos de CAPTCHA, mas você ainda pode encontrá-los. Integre um serviço de resolução de CAPTCHA (por exemplo, 2Captcha) no seu fluxo Selenium.
Conclusão
Combinar AdsPower com Beautiful Soup oferece uma pilha de web scraping poderosa e anônima. O AdsPower lida com a diversidade de impressões digitais e gerenciamento de proxy, enquanto o Beautiful Soup torna a análise de HTML muito fácil. Seja raspando dados de produtos, monitorando concorrentes ou agregando leads, essa dupla permite escalar sem ser bloqueado.
Comece com o plano gratuito do AdsPower, experimente os exemplos de código acima e expanda gradualmente para scraping multi-ambiente. Para mais comparações de navegadores anti-detecção, confira nosso guia AdsPower vs Indigo vs GoLogin ou aprenda como integrar AdsPower com Bright Data para um gerenciamento de proxy ainda melhor.
Feliz scraping – e fique indetectável!


