
Avaliação do Zyte 2026: Um Olhar Honesto sobre Sua API e Plataforma de Web Scraping
Take a Quick Look
Avaliação baseada em evidências do Zyte cobrindo API de web scraping, preços, configuração, extração por IA, rotação de proxy e usuários ideais. Veja como se compara para necessidades de dados em larga escala.
🔥 Limited-Time Offer! Save extra 10% off on your first monthly plan with code: Anitdetect10
Sign upAvaliação do Zyte 2026: Um Olhar Honesto sobre Sua API e Plataforma de Web Scraping
Encontrar uma solução de web scraping que funcione em escala sem se afogar em dores de cabeça de infraestrutura é uma façanha rara. O Zyte (a empresa anteriormente conhecida como Scrapinghub) promete resolver exatamente isso: uma plataforma tudo-em-um onde extração baseada em IA, gerenciamento inteligente de proxy e hospedagem em nuvem se fundem em uma única chamada de API. Esta avaliação do Zyte analisa o que a plataforma realmente entrega, quem mais se beneficia, onde ela brilha e onde mostra suas arestas — tudo baseado em dados disponíveis, opiniões dos usuários e capacidades internas da plataforma.
O que é o Zyte?
Avaliação do Zyte 2026: Um Olhar Honesto sobre Sua API e Plataforma de Web Scraping - interface do produto e visão geral dos recursos.
O Zyte é um ecossistema de extração de dados da web de ponta a ponta, projetado para empresas e desenvolvedores que precisam transformar páginas públicas em dados estruturados em grande escala. Em vez de juntar ferramentas separadas para proxies, navegadores headless e parsers, os usuários podem contar com a API unificada do Zyte para lidar com tudo, desde a rotação de IPs residenciais e renderização de JavaScript até a extração de uma saída JSON limpa.
A plataforma é construída sobre três pilares:
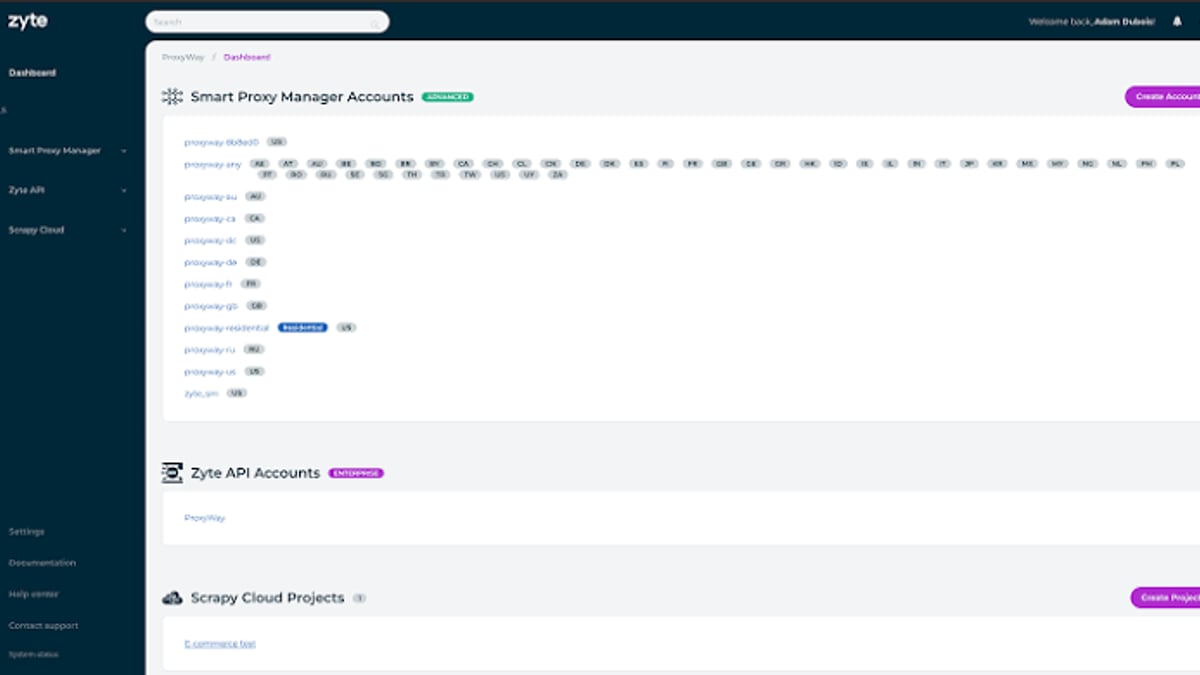
- API Zyte – Um endpoint de scraping automatizado com bypass anti-bot integrado, navegação headless e extração de dados alimentada por IA.
- Scrapy Cloud – Hospedagem em nuvem gerenciada para spiders Scrapy, oferecendo uma maneira simplificada de implantar, agendar e monitorar crawlers web.
- Gerenciador Inteligente de Proxy – Rotação inteligente de proxy que escolhe a melhor estratégia de IP com base no comportamento do site alvo, incluindo limitação automática e lógica de repetição.
Um quarto componente, Dados Zyte, fornece um serviço de entrega de dados totalmente gerenciado para equipes que preferem terceirizar todo o pipeline, da coleta ao conjunto de dados final. Essa abrangência torna o Zyte mais do que um kit de ferramentas; é uma plataforma full-stack que visa substituir a orquestra DIY de proxies, scrapers e parsers.
Quem Deve Usar o Zyte? Perfis de Usuário Ideais
Avaliação do Zyte 2026: Um Olhar Honesto sobre Sua API e Plataforma de Web Scraping - imagem de apoio à pesquisa do produto 2.
O Zyte não é um scraper de tamanho único. Seu valor se torna mais aparente quando alinhado ao caso de uso correto.
1. Equipes de negócios ávidas por dados
Para monitoramento de preços, inteligência competitiva ou pesquisa de mercado que exige milhares a milhões de pontos de dados públicos diariamente, a infraestrutura gerenciada economiza tempo de engenharia. A capacidade da plataforma de lidar com contramedidas anti-bot de forma transparente significa que os analistas de dados podem se concentrar em insights, em vez de detecção de bots.
2. Desenvolvedores e engenheiros de dados construindo scrapers personalizados
Se você já está familiarizado com o Scrapy, o Scrapy Cloud atua como um multiplicador de força: sem manutenção de servidor, escalonamento automático e painéis detalhados. Mesmo sem o Scrapy, as simples requisições POST da API Zyte reduzem a barreira para Python, Node.js ou qualquer linguagem compatível com cliente HTTP.
3. Agências e consultorias entregando projetos de dados
O serviço de dados gerenciados do Zyte (Dados Zyte) permite que agências vendam conjuntos de dados de alta qualidade sem criar um departamento interno de scraping. O preço previsível por requisição também simplifica o cálculo de custos do projeto.
Quando o Zyte pode ser exagero: Se você precisa extrair apenas um punhado de páginas estáticas ocasionalmente, um script leve com um proxy padrão pode ser suficiente. O valor do Zyte cresce com a complexidade dos alvos (sites com muito JavaScript, bloqueio agressivo de bots) e o volume de requisições.
Principais Recursos que Diferenciam o Zyte
Avaliação do Zyte 2026: Um Olhar Honesto sobre Sua API e Plataforma de Web Scraping - imagem de apoio à pesquisa do produto 3.
Vamos detalhar os recursos que aparecem consistentemente no feedback dos usuários e na documentação técnica, não apenas no marketing brilhante.
Extração Alimentada por IA que Aprende Padrões de Página
Em vez de escrever seletores XPath frágeis para cada site, a API Zyte pode identificar automaticamente detalhes de produtos, artigos ou vagas de emprego usando modelos de machine learning treinados na estrutura da web. Você envia uma URL e pede "nome do produto, preço, imagem" — a resposta vem estruturada, mesmo que o layout subjacente da página mude. Essa qualidade de autocura reduz drasticamente a manutenção, um fato citado positivamente em muitas avaliações do G2, onde os usuários destacam como a extração permanece confiável ao longo de meses.
Rotação de Proxy Integrada como Cidadão de Primeira Classe
O Gerenciador Inteligente de Proxy não é apenas uma lista de proxy; ele analisa padrões de resposta, banimentos e CAPTCHAs em tempo real. Ele alterna entre IPs residenciais, IPs de data center e IPs móveis automaticamente. Por ser profundamente integrado, você não gerencia sessões de proxy manualmente. Isso melhora drasticamente as taxas de sucesso em alvos que bloqueiam agressivamente scrapers — um ponto problemático comum visível no feedback de usuários no Trustpilot, onde clientes notam "capaz de contornar praticamente qualquer site alvo."
Scrapy Cloud para Spiders em Grau de Produção
O Scrapy, o framework de código aberto amplamente utilizado, ganha uma casa na nuvem com o Scrapy Cloud. Você obtém agendamento de jobs, spiders periódicas, monitoramento de logs e pipelines de exportação de dados sem trabalho DevOps. Para equipes que desejam controle total sobre a lógica da spider, mas sem sobrecarga de servidor, é o ponto ideal. A interface em nuvem inclui estatísticas em tempo real e integra-se com os serviços de proxy e extração do Zyte.
Estrutura de Preços Transparente por Requisição
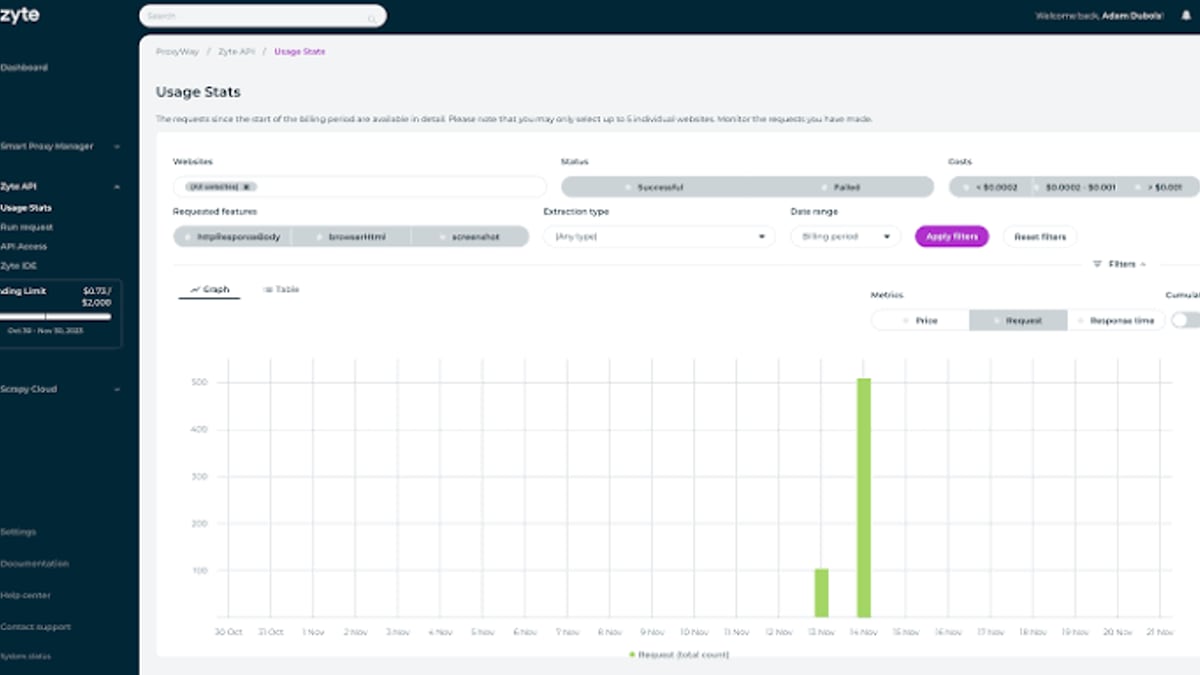
Em vez de níveis de assinatura opacos, o Zyte publica um modelo baseado em consumo. O ponto de entrada mais proeminente é $0,06 por 1.000 respostas bem-sucedidas para extração básica. Os custos escalam com a complexidade do site (renderização de JavaScript, extração por IA, proxy premium), então você não paga taxas pesadas de renderização em páginas estáticas. Isso permite modelar os custos diretamente em relação ao volume de dados — uma transparência elogiada por engenheiros de dados que odeiam surpresas na conta.
Preços do Zyte: Como os Custos Escalam com a Complexidade
Avaliação do Zyte 2026: Um Olhar Honesto sobre Sua API e Plataforma de Web Scraping - imagem de apoio à pesquisa do produto 4.
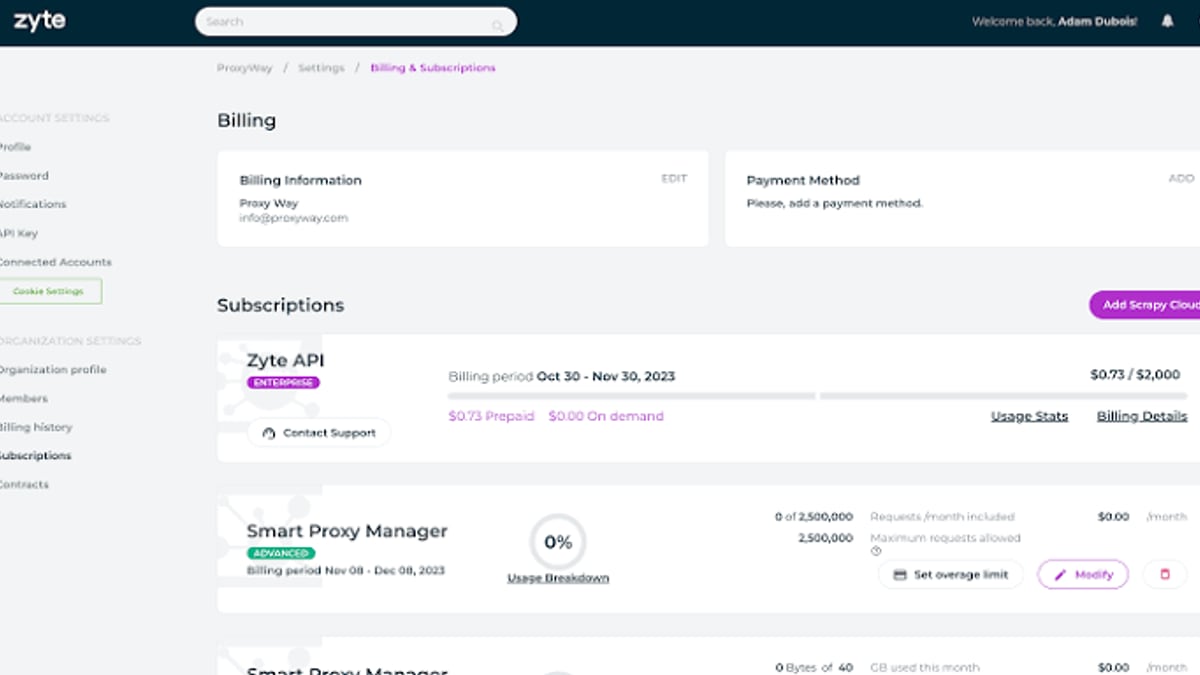
A precificação do Zyte se divide em componentes em camadas:
- Requisições: Custo base a partir de $0,06 por 1.000 requisições simples.
- Renderização de JavaScript: Taxa adicional por requisição quando navegadores headless são necessários.
- Extração por IA: Custo adicional por requisição quando a extração estruturada de dados é ativada.
- Uso de proxy: Incorporado na precificação da requisição, mas varia com a complexidade do alvo; proxies residenciais custam mais do que IPs de data center.
Uma regra prática útil: uma página de produto moderadamente complexa que precisa de renderização e extração por IA pode custar cerca de $0,20 por 1.000 requisições, mas alvos com alto anti-bot usando IPs residenciais premium aumentam o valor. O Zyte oferece uma calculadora de custos e uma cota de teste gratuito para projetar despesas. Para scraping empresarial em larga escala, existem planos personalizados com suporte dedicado e descontos por volume.
Devido a essa precificação modular, você pode começar pequeno e pagar apenas pelos recursos que ativar. Isso limita o desperdício se você estiver fazendo scraping de blogs estáticos em vez de listagens dinâmicas de e-commerce.
Configurando o Zyte: Primeiros Passos e Experiência do Desenvolvedor
Você não precisa instalar o Scrapy ou configurar gateways de proxy para fazer sua primeira requisição. O fluxo de trabalho mínimo é assim:
- Crie uma conta no Zyte e obtenha uma chave de API.
- Envie uma requisição POST para o endpoint da API Zyte com a URL de destino e as opções de extração desejadas (por exemplo,
"product": true). - Receba JSON estruturado com campos extraídos, status da resposta e metadados.
Exemplo de código (Python):
import requests

response = requests.post(
    "https://api.zyte.com/v1/extract",
    auth=("SUA_CHAVE_API", ""),
    json={"url": "https://books.toscrape.com", "product": True}
)
data = response.json()
print(data["product"])
Para usuários do Scrapy, implantar uma spider no Scrapy Cloud é feito através da ferramenta de linha de comando shub ou integração com GitHub. O ambiente automaticamente carrega o middleware zyte-smartproxy. A documentação é sólida, embora iniciantes absolutos possam achar o número de opções esmagador no início. No entanto, o suporte ao cliente — frequentemente elogiado nas avaliações do Trustpilot — rapidamente preenche essas lacunas.
Pontos Fortes e Limitações do Zyte com Base no Uso no Mundo Real
Pontos Fortes
- Altas taxas de sucesso em alvos difíceis: Usuários relatam consistentemente que a rotação de proxy e o fingerprinting do navegador do Zyte contornam até sistemas anti-bot sofisticados.
- Manutenção reduzida: A extração por IA se adapta a mudanças de layout, eliminando a necessidade de reescrever seletores mensalmente.
- Escalabilidade pronta para uso: A infraestrutura em nuvem lida com grandes volumes de requisições sem gerenciamento de fila por sua parte.
- APIs e SDKs amigáveis ao desenvolvedor: Endpoints REST limpos e integrações com Python/Scrapy reduzem o tempo de integração.
- Custos transparentes: A precificação por requisição evita choques na fatura e alinha o custo com dados utilizáveis.
Limitações
- Custo pode ser alto para sites de baixo volume, mas complexos: Se você precisa de apenas 5.000 páginas de produto por mês de um site difícil de raspar, a taxa por requisição pode parecer alta em comparação com uma configuração DIY de proxy + navegador headless.
- Curva de aprendizado para não programadores: Embora a API seja simples, usuários de negócios muitas vezes ainda precisam de ajuda de desenvolvedores para criar esquemas de extração.
- Aprisionamento tecnológico na lógica de extração: Se você personalizar fortemente a extração por meio das dicas de IA do Zyte, migrar para outra plataforma pode exigir reconstruir as regras de parsing.
- Picos ocasionais de latência: Como em qualquer serviço baseado em proxy, sites alvo extremamente agressivos podem introduzir pequenos atrasos, apesar das repetições automáticas.
Como o Zyte se Compara às Alternativas
Ao avaliar as principais plataformas de proxy e web scraping para 2026, o Zyte ocupa um meio-termo único entre serviços de dados totalmente gerenciados e ferramentas faça-você-mesmo. Compare com uma rede de proxy pura como a da nossa Análise de Rede de Proxy, onde você obtém IPs, mas precisa gerenciar a lógica de scraping por conta própria. O Zyte agrupa essa inteligência.
Em comparação com Bright Data ou Oxylabs (que oferecem tecnologias "desbloqueadoras" semelhantes), o Zyte se diferencia por sua profunda integração com o Scrapy e extração por IA que aprende esquemas de página. No entanto, concorrentes às vezes oferecem pools de proxy maiores ou preços residenciais mais flexíveis em volumes massivos. A escolha se resume a se você valoriza uma plataforma integrada com hospedagem nativa de spiders e IA de extração em vez de blocos de construção à la carte.
Para equipes que já usam navegadores anti-detecção para gerenciar várias contas — como o AdsPower — a renderização com navegador headless do Zyte pode complementar esses fluxos de trabalho, mas eles servem a propósitos primários diferentes. O Zyte se destaca na extração automatizada em massa, enquanto os navegadores anti-detecção focam no gerenciamento manual ou semiautomatizado de contas. Combinar ambos frequentemente forma uma pilha robusta de coleta de dados.
Leitura relacionada
- Top 10 Plataformas de Mídia Social em 2026: Rankings Baseados em Dados - Nossa classificação baseada em evidências das 10 principais plataformas de mídia social em 2026, com estatísticas de usuários, tendências de crescimento e casos de uso empresarial para ajudá-lo a escolher os canais certos.
- Avaliação do Incogniton 2025: Recursos, Preços e Veredito Honesto - Avaliação baseada em evidências do Incogniton: veja como este navegador anti-detecção lida com gerenciamento de várias contas, fingerprinting, configuração de proxy e se é adequado para você em 2025.
Fontes e leitura adicional
- Avaliações do Zyte (73): Prós e Contras de Trabalhar na Zyte - 73 avaliações do Zyte. Uma visão interna gratuita das avaliações e salários da empresa postados anonimamente pelos funcionários.
Perguntas Frequentes
O Zyte é adequado para projetos de scraping de pequena escala?
Pode ser, mas se torna custo-efetivo apenas ao raspar sites complexos, bloqueados ou com muito JavaScript. Para algumas centenas de páginas estáticas, um script simples com proxies gratuitos pode ser suficiente. O Zyte brilha quando a manutenção manual se torna insustentável.
Como o Zyte lida com renderização de JavaScript?
A API Zyte detecta automaticamente se uma página requer JavaScript e inicia uma instância de navegador headless. Você paga uma taxa adicional de renderização por requisição. O processo é transparente; basta definir "browserHtml": true na sua requisição ou deixar a detecção automática decidir.
Qual é a diferença entre a API Zyte e o Scrapy Cloud?
A API Zyte é um endpoint de scraping gerenciado: você envia uma URL e recebe dados estruturados sem escrever lógica de crawler. O Scrapy Cloud é hospedagem para suas próprias spiders Scrapy personalizadas, dando controle total sobre as regras de crawling e pipelines de dados. Muitas equipes usam ambos: Scrapy Cloud para lógicas complexas e API Zyte para extrações rápidas.
O Zyte pode contornar paredes de login e CAPTCHAs?
O Zyte pode buscar páginas atrás de paredes de login se você fornecer credenciais/cookies via API. Para CAPTCHAs, o Gerenciador Inteligente de Proxy repete automaticamente com IPs mais limpos, mas não resolve CAPTCHAs baseados em imagem inerentemente. Na prática, a maioria dos usuários relata taxas de sucesso muito altas sem lidar manualmente com CAPTCHAs.
O Zyte oferece um teste gratuito?
Sim, novas contas recebem uma cota de crédito gratuita que permite testar a API e a qualidade da extração antes de se comprometer. Esta é a melhor maneira de avaliar as taxas de sucesso nos seus sites alvo específicos.
Conclusão
O Zyte conquista sua forte reputação — refletida em uma média de 4,4 estrelas no G2 e elogios consistentes dos clientes — ao resolver as partes mais dolorosas do web scraping em larga escala: detecção de bots, renderização de JavaScript e estruturação de dados. Ele substitui uma pilha de ferramentas fragmentadas por uma única plataforma que escala de algumas centenas de requisições para milhões, mantendo a precificação previsível. Para equipes orientadas a dados, analistas e desenvolvedores que valorizam confiabilidade em vez de ajustes de baixo nível, o Zyte é uma escolha convincente.
Onde é menos ideal: projetos de baixo volume com alvos simples, ou organizações que precisam de controle máximo sobre cada salto de proxy e largura de banda. Mas para a maioria dos casos de uso empresarial — monitoramento competitivo, enriquecimento de leads, análise de mercado — o modelo tudo-em-um do Zyte reduz tanto o tempo de desenvolvimento quanto a sobrecarga de manutenção contínua. Se você está pronto para transformar dados da web em um ativo confiável, em vez de um constante combate a incêndios, o Zyte vale uma avaliação séria. Para equipes que posteriormente precisam obter insights de SEO ou conteúdo desses dados raspados, plataformas como AdsPower podem ajudar a transformar conjuntos de dados estruturados em estratégia acionável sem começar do zero.