
Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026
Швидкий огляд
Експертний рейтинг 10 найкращих фреймворків для веб-скрапінгу з відкритим кодом у 2026 році. Порівняння Scrapy, Crawlee, Playwright, Crawl4AI та інших. Чесно про переваги, недоліки та сценарії використання.
Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026
Веб-скрапінг у 2026 році — це ландшафт зрілих, перевірених у бою фреймворків та інноваційних новачків. Чи ви будуєте конвеєр даних продакшн-масштабу, живите LLM або автоматизуєте разове вилучення, вибір правильного фреймворку з відкритим кодом може заощадити місяці часу на розробку та безліч головних болів.
Цей список ранжує топ-10 фреймворків для веб-скрапінгу з відкритим кодом на основі п'яти прозорих критеріїв: здоров'я підтримки, дозвільність ліцензії, продакшн-здатність, стеля антибот-захисту та якість документації. Ми виключили будь-який інструмент, який в першу чергу служить клієнтською бібліотекою для платного API або має заархівований репозиторій. Кожен запис підтримується незалежно і є справді відкритим кодом.
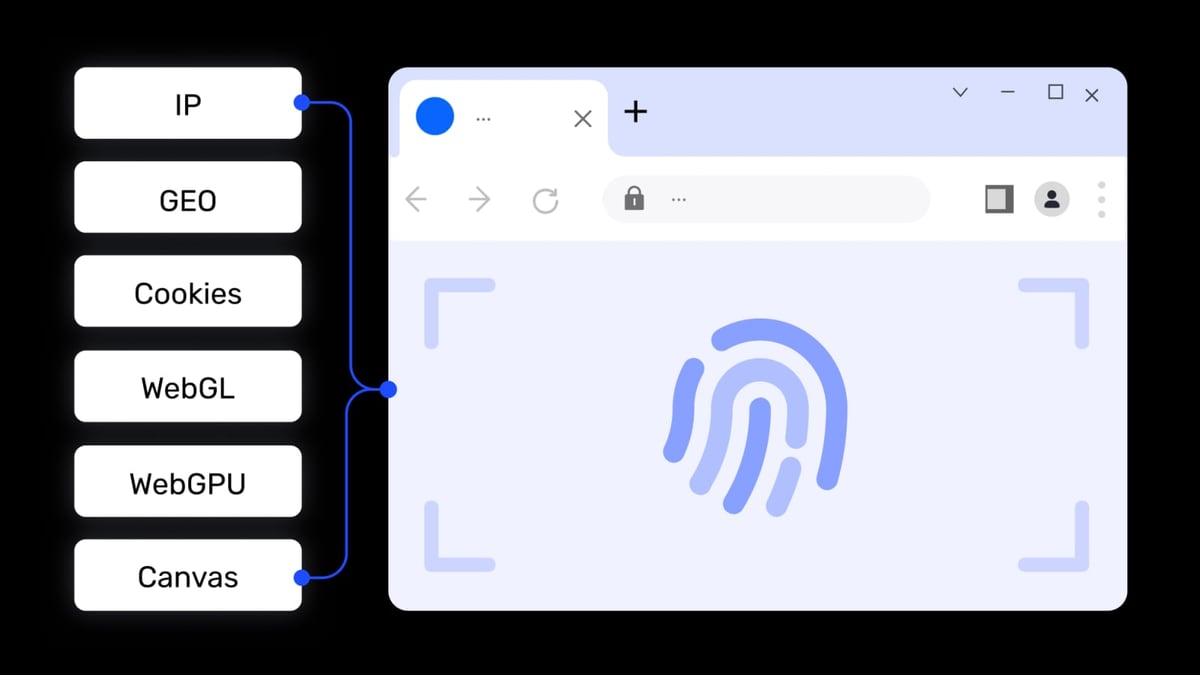
Якщо ваш робочий процес передбачає управління кількома обліковими записами для скрапінгу або уникнення банів на платформах, вам також може знадобитися антидетект-браузер, такий як AdsPower, щоб ізолювати відбитки браузера та конфігурації проксі. Ми торкнемося цього там, де це доречно.
Як ми ранжували ці фреймворки
Огляд інтерфейсу та функцій продукту Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026.
| Критерій | Вага | Що ми перевіряли |
|---|---|---|
| Здоров'я підтримки | 30% | Нещодавні коміти, кількість контриб'юторів, час відповіді на issues |
| Ліцензія | 20% | Перевага дозвільним (BSD, MIT, Apache) над копілефт (AGPL) |
| Продакшн-здатність | 25% | Масштабованість, проміжне ПЗ, управління чергами, формати експорту |
| Стеля антибот-захисту | 15% | Вбудована обробка відбитків, ротація проксі, стелс-функції |
| Документація та спільнота | 10% | Туторіали, приклади, активність на форумах, зірки GitHub (як вторинний сигнал) |
Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026
Огляд інтерфейсу та функцій продукту Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026.
1. Scrapy – Найкращий для продакшн-скрапінгу на Python
Зірки: ~63k · Ліцензія: BSD-3-Clause · Мова: Python
Scrapy залишається золотим стандартом для великомасштабного, структурованого веб-скрапінгу на Python. Підтримуваний спільнотою понад 15 років з внесками від Zyte та 500+ розробників, він надає повний каркас проекту: павуки, конвеєри елементів, проміжне ПЗ та експорт фідів. Вбудоване розширення AutoThrottle автоматично регулює швидкість запитів для дотримання лімітів сервера.
Сильні сторони:
- Зрілий, перевірений у продакшні в різних галузях
- Розширюваний через проміжне ПЗ та конвеєри
- Експорт фідів у JSON, CSV, XML, S3 та інші
- Велика екосистема додатків (scrapy-playwright для JS-рендерингу, scrapy-zyte-api для антибану)
Обмеження:
- Тільки HTTP за замовчуванням; сайти з великою кількістю JavaScript вимагають інтеграції з Playwright або Splash
- Крутіша крива навчання, ніж написання ad-hoc скриптів
- Немає вбудованого управління проксі або вирішення CAPTCHA
Найкраще для: Структурованих, повторюваних, високооб'ємних обходів у командах Python.
import scrapy

class ProductSpider(scrapy.Spider):
    name = "products"
    start_urls = ["https://web-scraping.dev/products"]

    def parse(self, response):
        for product in response.css("div.product"):
            yield {
                "title": product.css("h3 a::text").get(),
                "price": product.css(".product-price::text").get(),
                "url": response.urljoin(product.css("h3 a::attr(href)").get()),
            }
        next_page = response.css("a[rel=next]::attr(href)").get()
        if next_page:
            yield response.follow(next_page, callback=self.parse)
2. Crawlee – Найкращий універсальний скрапер для Node.js
Зірки: ~24k · Ліцензія: Apache-2.0 · Мова: JavaScript/TypeScript, Python (бета)
Crawlee — це найбільш укомплектований фреймворк для веб-скрапінгу з відкритим кодом для Node.js. Він об'єднує HTTP-скрапінг (CheerioCrawler) та скрапінг з headless-браузером (PlaywrightCrawler, PuppeteerCrawler) під єдиним API, з вбудованими чергами запитів, пулами сесій та хуками ротації проксі.
Сильні сторони:
- Автомасштабована конкурентність та постійні черги
- Контексти браузера з урахуванням відбитків
- Ліцензія Apache-2.0, незалежна підтримка
- Python-порт в активній розробці
Обмеження:
- Python-версія менш зріла, ніж Scrapy
- Режим браузера вимогливий до ресурсів
Найкраще для: Команд Node.js, які хочуть готовий до продакшну фреймворк без збирання компонентів з нуля.
import { CheerioCrawler } from "crawlee";

const crawler = new CheerioCrawler({
    async requestHandler({ $, request }) {
        const books = [];
        $("article.product_pod").each((_, el) => {
            books.push({
                title: $(el).find("h3 a").attr("title"),
                price: $(el).find(".price_color").text(),
            });
        });
        console.log(`Scraped ${books.length} books from ${request.url}`);
    },
});
await crawler.addRequests(["https://books.toscrape.com"]);
await crawler.run();
3. Playwright – Найкращий для сайтів з великою кількістю JavaScript
Зірки: ~92k · Ліцензія: Apache-2.0 · Мова: Python, Node.js, Java, .NET
Playwright, який підтримується Microsoft, є провідною бібліотекою автоматизації браузера для скрапінгу односторінкових додатків та динамічного контенту. Він підтримує Chromium, Firefox та WebKit, з автоматичним очікуванням, перехопленням мережі та емуляцією мобільних пристроїв.
Сильні сторони:
- Обробляє будь-яку сторінку з JavaScript-рендерингом
- Підтримка кількох браузерів
- Відмінна документація та активна розробка
- Може перехоплювати та змінювати мережеві запити
Обмеження:
- Вимогливий до ресурсів (кожен екземпляр браузера споживає значну пам'ять)
- Повільніший, ніж HTTP-скрапінг
- Стандартні конфігурації легко виявляються антибот-системами; потрібні стелс-патчі
Найкраще для: Скрапінгу сторінок, де контент існує лише після виконання JavaScript.
4. Crawl4AI – Найкращий для конвеєрів LLM та RAG
Зірки: ~70k · Ліцензія: Apache-2.0 · Мова: Python
Crawl4AI створений спеціально для живлення AI-моделей. Він виводить чистий Markdown (на 67% менше токенів, ніж сирий HTML), підтримує структуроване вилучення зі схемами Pydantic та інтегрується нативно з LangChain і LlamaIndex.
Сильні сторони:
- Вивід Markdown, готовий для LLM
- AI-кероване вилучення, яке адаптується до змін на сайті
- Швидкий (відповідь менш ніж за 3 секунди на більшості сторінок)
- Відповідність SOC 2 Type II
Обмеження:
- Відносно молодий; менша екосистема, ніж у Scrapy
- Найкраще підходить для AI-конвеєрів, а не для загального скрапінгу
Найкраще для: Команд, які будують RAG-системи, AI-агенти або канали даних для LLM.
from firecrawl import Firecrawl
from pydantic import BaseModel, Field
from typing import List

class Repository(BaseModel):
    name: str = Field(description="The name of the repository")
    stars: int = Field(description="The number of stars")

class RepoList(BaseModel):
    repos: List[Repository]

app = Firecrawl(api_key="fc-YOUR_API_KEY")
result = app.scrape(
    url="https://github.com/trending",
    formats=["json"],
    json_options={"schema": RepoList.model_json_schema()}
)
print(result.json())
5. Camoufox – Найкращий для цілей із захистом відбитків
Зірки: ~9.7k · Ліцензія: MPL-2.0 · Мова: Python
Camoufox — це інструмент автоматизації браузера на основі Firefox, призначений для ухилення від виявлення за відбитками. Він рандомізує відбитки Canvas, WebGL, Audio та WebRTC, що робить його ефективним проти сайтів, які блокують headless-браузери.
Сильні сторони:
- Вбудована рандомізація відбитків
- Обробляє JavaScript-рендеринг
- Легший порівняно з повноцінними наборами автоматизації браузера
Обмеження:
- Менша спільнота та менше інтеграцій
- Ліцензія MPL-2.0 може вимагати уваги до відповідності
Найкраще для: Скрапінгу цілей, захищених відбитками браузера (наприклад, платформи квитків, соціальні мережі).
Примітка: Для управління кількома обліковими записами в масштабі поєднання Camoufox з антидетект-браузером, таким як AdsPower, може забезпечити додаткову ізоляцію відбитків та ротацію проксі. Дивіться наш посібник Як використовувати AdsPower з SOAX для покрокового робочого процесу.
6. Puppeteer – Найкращий для Chrome-орієнтованого скрапінгу на Node.js
Зірки: ~95k · Ліцензія: Apache-2.0 · Мова: Node.js
Puppeteer, розроблений Google, надає високорівневий API для керування Chrome/Chromium. Він відмінно підходить для автоматизації взаємодій з браузером, створення скріншотів та обходу SPA.
Сильні сторони:
- Глибока інтеграція з Chrome DevTools Protocol
- Перехоплення мережі та блокування запитів
- Велика екосистема високорівневих фреймворків (наприклад, Crawlee)
Обмеження:
- Тільки Chrome (немає підтримки Firefox або Safari)
- Вимогливий до ресурсів
- Для захищених сайтів потрібна стелс-конфігурація
Найкраще для: Chrome-орієнтованого скрапінгу та тестування на Node.js.
7. Selenium – Найкраще покриття мов
Зірки: ~34k · Ліцензія: Apache-2.0 · Мова: Python, Java, C#, Ruby, JavaScript
Selenium — це найбільш мовно-агностичний фреймворк автоматизації браузера. Він підтримує всі основні браузери та має найбільшу екосистему драйверів та інтеграцій.
Сильні сторони:
- Найширша підтримка мов
- Працює з будь-яким браузером
- Велика документація та спільнота
Обмеження:
- Повільніший та вимогливіший до ресурсів, ніж Playwright
- Немає вбудованого автоматичного очікування (потрібні явні очікування)
- Стандартні конфігурації легко виявляються
Найкраще для: Багатомовних команд або проектів, які повинні підтримувати застарілі браузери.
8. Scrapling – Найкраща сучасна бібліотека скрапінгу на Python
Зірки: ~67k · Ліцензія: BSD-3-Clause · Мова: Python
Scrapling — це сучасна Python-бібліотека, яка поєднує HTTP-отримання з інтелектуальним парсингом. Вона має автоматичне виявлення пагінації, адаптивні селектори та вбудовану логіку повторних спроб.
Сильні сторони:
- Чистий, сучасний API
- Автоматичне виявлення пагінації
- Легкий та швидкий
Обмеження:
- Немає вбудованого JavaScript-рендерингу (потрібен зовнішній завантажувач)
- Молодший проект з меншою кількістю ресурсів спільноти
Найкраще для: Python-розробників, які хочуть простішу альтернативу Scrapy для проектів середнього масштабу.
9. Colly – Найкращий скрапер з відкритим кодом для Go
Зірки: ~25k · Ліцензія: Apache-2.0 · Мова: Go
Colly — це провідний фреймворк для веб-скрапінгу на Go. Він надає чистий API для паралельного обходу, кешування та фільтрації URL, а також компілюється в єдиний бінарний файл без залежностей часу виконання.
Сильні сторони:
- Блискавична продуктивність
- Розгортання одним бінарним файлом
- Вбудоване кешування та обмеження швидкості
Обмеження:
- Немає JavaScript-рендерингу
- Менша екосистема, ніж у фреймворків Python/Node.js
Найкраще для: Go-команд, які будують високопродуктивні конвеєри скрапінгу.
10. Maxun – Найкращий no-code скрапер з відкритим кодом
Зірки: ~16k · Ліцензія: AGPL-3.0 · Мова: TypeScript
Maxun — це самостійно розміщена no-code платформа для скрапінгу. Ви навчаєте робота, демонструючи кліки та вибірки у своєму браузері, і він генерує багаторазовий скрапер.
Сильні сторони:
- Справжній no-code інтерфейс
- Самостійне розміщення (дані залишаються на вашій інфраструктурі)
- Обробляє JavaScript-рендеринг
Обмеження:
- Ліцензія AGPL може обмежувати комерційне використання
- Менш гнучкий, ніж кодові фреймворки для складної логіки
- Менша спільнота
Найкраще для: Не-розробників або команд, яким потрібен швидкий візуальний скрапінг без написання коду.
Таблиця порівняння
Огляд інтерфейсу та функцій продукту Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026.
| Фреймворк | Мова | Ліцензія | Зірки | JS-рендеринг | Найкраще для |
|---|---|---|---|---|---|
| Scrapy | Python | BSD-3 | ~63k | Плагін | Продакшн-обходи на Python |
| Crawlee | JS/TS, Python | Apache-2 | ~24k | Так | Універсальний скрапінг Node.js |
| Playwright | Багато | Apache-2 | ~92k | Так | Сайти з великою кількістю JavaScript |
| Crawl4AI | Python | Apache-2 | ~70k | Так | Конвеєри LLM/RAG |
| Camoufox | Python | MPL-2 | ~9.7k | Так | Цілі з захистом відбитків |
| Puppeteer | Node.js | Apache-2 | ~95k | Так | Chrome-орієнтований скрапінг |
| Selenium | Багато | Apache-2 | ~34k | Так | Найширше покриття мов |
| Scrapling | Python | BSD-3 | ~67k | Залежить від завантажувача | Сучасний скрапінг на Python |
| Colly | Go | Apache-2 | ~25k | Ні | Скрапінг на Go |
| Maxun | TypeScript | AGPL-3 | ~16k | Так | No-code самостійне розміщення |
Коли фреймворки з відкритим кодом досягають своїх меж
Огляд інтерфейсу та функцій продукту Топ-10 фреймворків для веб-скрапінгу з відкритим кодом 2026.
Жоден фреймворк з відкритим кодом не надає пули резидентних IP, вирішення CAPTCHA або керований обхід антибот-захисту в масштабі. Цей операційний рівень є реальною вартістю. Для цілей, захищених Cloudflare, DataDome або Akamai, вам потрібно буде поєднати ваш фреймворк з проксі-сервісами та управлінням відбитками.
Якщо ви керуєте кількома обліковими записами для скрапінгу або потребуєте ротації відбитків браузера, антидетект-браузер, такий як AdsPower, може надати ізольовані середовища з унікальними відбитками. Для глибшого порівняння дивіться нашу статтю AdsPower vs VMLogin vs Dolphin Anty.
Щодо потреб у проксі, ознайомтеся з нашим Оглядом проксі-сервісів IPBurger та Оглядом PROXYS.IO.
Пов'язане читання
- AdsPower Fingerprint Browser vs Hidemyacc vs Genlogin: Порівняння 2026 - Порівняння антидетект-браузерів AdsPower, Hidemyacc та Genlogin для управління кількома обліковими записами. Дивіться сильні сторони, недоліки та який інструмент підходить для вашого робочого процесу.
Джерела та додаткове читання
- Найкращі бібліотеки веб-скрапінгу з відкритим кодом у 2026 році - Всебічне порівняння провідних інструментів веб-скрапінгу, включаючи Firecrawl, з висвітленням AI-рішень, традиційних методів та як вибрати правильну бібліотеку для ваших потреб вилучення даних.
- 10 найкращих веб-скраперів з відкритим кодом у 2026 році - 10 найкращих веб-скраперів з відкритим кодом у 2026 році, ранжованих за підтримкою, ліцензією та стелею антибот-захисту. Охоплює Scrapy, Crawlee, Playwright, Camoufox, Crawl4AI, Colly
- Топ-10 інструментів веб-скрапінгу у 2026 році — і коли жоден з них не є достатнім - Честний огляд 10 найпопулярніших інструментів веб-скрапінгу у 2026 році — реальні плюси, реальні мінуси, ціни та коли готові інструменти не спрацьовують, і вам потрібен кастомний скрапер.
FAQ
Який фреймворк для веб-скрапінгу з відкритим кодом найкращий для початківців?
Scrapling (Python) або Crawlee (Node.js) пропонують найпростіші криві навчання з сучасними API. Для no-code Maxun є найкращою точкою входу.
Чи можна використовувати Scrapy зі сторінками, що рендеряться JavaScript?
Так, шляхом інтеграції scrapy-playwright або scrapy-splash. Дивіться документацію Scrapy для налаштування.
Який найкращий фреймворк для подачі даних в LLM?
Crawl4AI створений спеціально для цього, виводячи чистий Markdown з мінімальною кількістю токенів. Він інтегрується безпосередньо з LangChain та LlamaIndex.
Чи потрібен мені антидетект-браузер для веб-скрапінгу?
Тільки якщо ваша ціль використовує відбитки браузера для блокування автоматизації. Camoufox обробляє базову рандомізацію відбитків. Для робочих процесів з кількома обліковими записами AdsPower забезпечує більш надійну ізоляцію.
Чи є фреймворки, яких слід уникати у 2026 році?
Уникайте будь-якого проекту, чий репозиторій GitHub був заархівований або який в першу чергу є клієнтом для платного API. Завжди перевіряйте дату останнього коміту та ліцензію перед використанням.
Висновок
Найкращий фреймворк для веб-скрапінгу з відкритим кодом у 2026 році залежить від вашої мови, масштабу та складності цілі. Scrapy залишається неперевершеним для продакшн-обходів на Python. Crawlee є найсильнішим універсальним вибором для Node.js. Playwright надійно обробляє динамічний контент. Crawl4AI лідирує в епоху AI з виводом, готовим для LLM. А Camoufox заповнює нішу ухилення від відбитків.
Жоден інструмент не вирішує всі проблеми. Комбінуйте фреймворки з проксі-сервісами, антидетект-браузерами та моніторингом, щоб побудувати повний конвеєр даних. Почніть з таблиці вище, підберіть вашу основну вимогу та ітеруйте звідти.
Для подальшого читання дивіться наш Огляд Scrapestack та Огляд ScrapingBee для альтернатив керованого API.


