
Como Usar o Navegador de Impressão Digital AdsPower com Scrapy
Take a Quick Look
Aprenda a integrar o navegador anti-detecção AdsPower com Scrapy para web scraping furtivo. Guia passo a passo, exemplos de código e dicas de fluxo de trabalho.
🔥 Limited-Time Offer! Save extra 10% off on your first monthly plan with code: Anitdetect10
Sign upComo Usar o Navegador de Impressão Digital AdsPower com Scrapy
O web scraping em grande escala frequentemente aciona medidas anti-bot que bloqueiam ou identificam seu raspador. Combinar o navegador de impressão digital AdsPower com o Scrapy oferece um pipeline de scraping poderoso e furtivo. O AdsPower fornece ambientes de navegador isolados com impressões digitais únicas, enquanto o Scrapy lida com o rastreamento e extração de dados. Juntos, eles resolvem problemas de associação de contas, bloqueio de IP e detecção de impressão digital do navegador.
Este guia aborda o fluxo de trabalho de integração, etapas de configuração, exemplos práticos de código e os problemas específicos que essa combinação resolve.
Por que Combinar AdsPower com Scrapy?
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
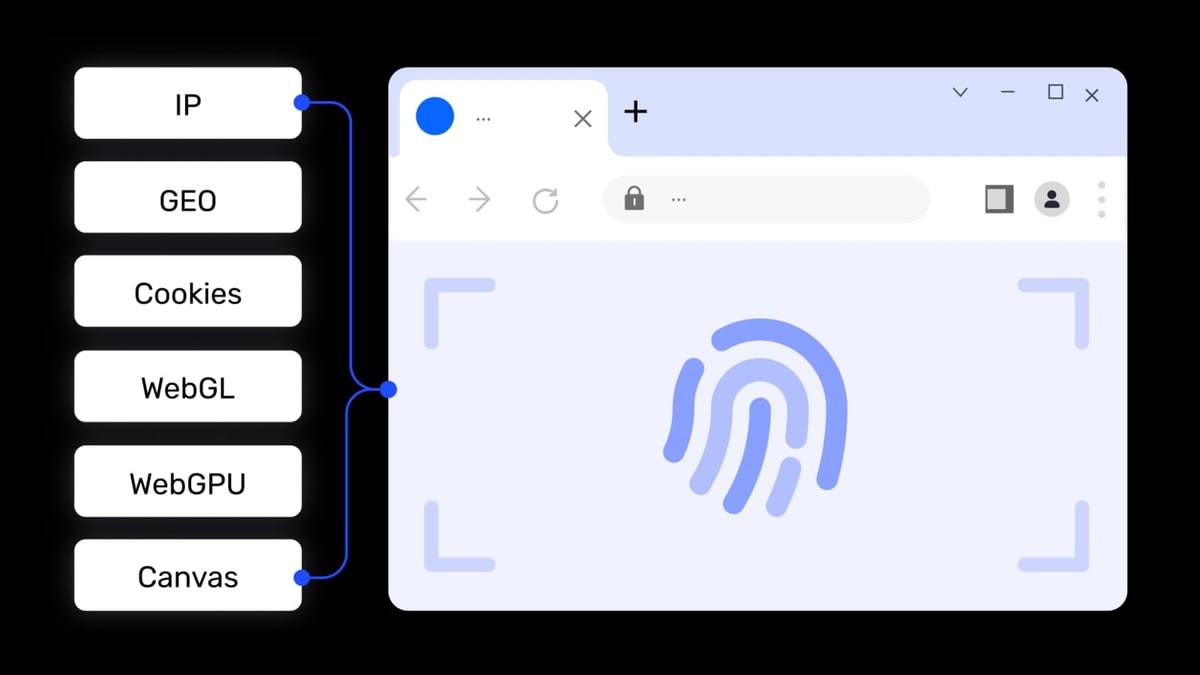
O Scrapy é um framework Python rápido e assíncrono para extrair dados de sites. No entanto, ele usa requisições HTTP brutas por padrão, o que facilita a detecção e bloqueio de raspadores pelos sites. O AdsPower cria ambientes de navegador reais com impressões digitais personalizáveis (Canvas, WebGL, Áudio, WebRTC, etc.), fazendo cada sessão parecer um usuário único em um dispositivo diferente.
Problemas resolvidos por esta combinação:
- Detecção de impressão digital do navegador – O AdsPower falsifica mais de 20 parâmetros de impressão digital, fazendo cada spider do Scrapy parecer um navegador novo.
- Associação de contas – Gerencie múltiplas contas em plataformas como Amazon, Facebook ou TikTok sem vinculá-las.
- Bloqueio de IP – Combine o AdsPower com proxies rotativos para distribuir requisições entre IPs.
- Renderização JavaScript – O Scrapy pode usar o navegador do AdsPower para renderizar conteúdo dinâmico que requisições HTTP brutas não capturam.
Como Funciona a Integração
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
O fluxo de trabalho tem três componentes principais:
- API Local do AdsPower – Inicia e controla ambientes de navegador programaticamente.
- Spider do Scrapy – Usa o ambiente do navegador para enviar requisições e analisar respostas.
- Gerenciamento de proxy – Cada perfil do AdsPower pode receber um proxy único.
Aqui está o fluxo de alto nível:
- Seu spider do Scrapy chama a API Local do AdsPower para iniciar um perfil de navegador específico.
- O AdsPower lança uma instância do navegador com uma impressão digital e proxy únicos.
- O spider usa esse navegador (via Selenium, Playwright ou HTTP direto) para raspar dados.
- Após a raspagem, o spider fecha o navegador através da API.
Pré-requisitos
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
Antes de começar, certifique-se de ter:
- AdsPower instalado e em execução (v3.3.2+ recomendado). Baixar AdsPower
- Python 3.7+ instalado.
- Scrapy instalado:
pip install scrapy - Biblioteca Requests:
pip install requests - Opcional: Selenium ou Playwright se precisar de automação completa do navegador.
Guia de Configuração Passo a Passo
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
1. Ativar a API Local do AdsPower
Abra o AdsPower, vá em Configurações > API e anote a porta da API (padrão é 50325). Mantenha o cliente AdsPower em execução em segundo plano.
2. Criar um Perfil de Navegador
No AdsPower, crie um novo perfil de navegador. Atribua um proxy (HTTP, HTTPS, SOCKS5) se necessário. Anote o user_id do perfil – você o usará nas chamadas de API.
3. Instalar o Scrapy e Criar um Projeto
pip install scrapy
scrapy startproject adspower_scraper
cd adspower_scraper
4. Escrever o Auxiliar da API do AdsPower
Crie um arquivo adspower_api.py na pasta do seu projeto:
import requests

API_BASE = "http://127.0.0.1:50325"

def start_browser(user_id):
    url = f"{API_BASE}/api/v1/browser/start"
    params = {"user_id": user_id}
    response = requests.get(url, params=params)
    data = response.json()
    if data["code"] != 0:
        raise Exception(f"Falha ao iniciar o navegador: {data['msg']}")
    return data["data"]["debug_port"]

def close_browser(user_id):
    url = f"{API_BASE}/api/v1/browser/stop"
    params = {"user_id": user_id}
    requests.get(url, params=params)
5. Criar um Spider do Scrapy que Usa o AdsPower
Aqui está um spider que raspa uma URL alvo usando um ambiente de navegador iniciado pelo AdsPower:
import scrapy
from scrapy.http import HtmlResponse
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from .adspower_api import start_browser, close_browser

class AdspowerSpider(scrapy.Spider):
    name = "adspower_spider"
    allowed_domains = ["example.com"]
    start_urls = ["http://example.com"]

    def __init__(self, user_id=None, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.user_id = user_id or "seu_user_id_aqui"

    def start_requests(self):
        # Iniciar o perfil do navegador AdsPower
        debug_port = start_browser(self.user_id)
        self.logger.info(f"Navegador iniciado na porta de depuração {debug_port}")

        # Conectar Selenium ao navegador existente
        chrome_options = Options()
        chrome_options.add_experimental_option("debuggerAddress", f"127.0.0.1:{debug_port}")
        driver = webdriver.Chrome(options=chrome_options)

        for url in self.start_urls:
            driver.get(url)
            body = driver.page_source
            response = HtmlResponse(url=url, body=body, encoding='utf-8')
            yield response

        driver.quit()
        close_browser(self.user_id)

    def parse(self, response):
        # Extrair dados usando seletores do Scrapy
        title = response.css('title::text').get()
        yield {"title": title}
6. Executar o Spider
scrapy crawl adspower_spider -a user_id=SEU_USER_ID
Exemplo Prático: Raspagem de Página de Produto de E-commerce
Vamos raspar preços de produtos de um site de e-commerce que usa impressão digital.
- Crie um perfil AdsPower com um proxy de IP residencial.
- Use o spider acima, mas substitua
start_urlspela URL do produto. - Em
parse(), extraia preço, nome e disponibilidade.
def parse(self, response):
    product_name = response.css('h1.product-title::text').get()
    price = response.css('span.price::text').get()
    yield {
        "name": product_name,
        "price": price,
        "url": response.url
    }
Cada execução do spider usa uma impressão digital de navegador nova, fazendo a requisição parecer de um novo visitante.
Avançado: Usando Playwright com AdsPower e Scrapy
Para sites com muito JavaScript, use Playwright em vez de Selenium:
from playwright.sync_api import sync_playwright

def fetch_page(url, debug_port):
    with sync_playwright() as p:
        browser = p.chromium.connect_over_cdp(f"http://127.0.0.1:{debug_port}")
        page = browser.new_page()
        page.goto(url)
        content = page.content()
        browser.close()
        return content
Depois, chame isso no start_requests do seu spider.
Problemas Comuns e Soluções
| Problema | Solução |
|---|---|
| API retorna código de erro | Certifique-se de que o cliente AdsPower está em execução e a porta da API está correta |
| Navegador não fecha | Chame close_browser() no método closed() do spider |
| Impressão digital ainda detectada | Atualize o AdsPower para a versão mais recente; verifique as configurações de falsificação de impressão digital |
| Proxy não funciona | Verifique o formato do proxy no perfil AdsPower (HTTP/SOCKS5) |
Leitura Relacionada
- AdsPower vs Linken Sphere vs VMLogin: Comparação de Navegadores Anti-Detecção 2026 - Compare os navegadores anti-detecção AdsPower, Linken Sphere e VMLogin. Recursos, automação, segurança, preços e qual se adequa ao seu fluxo de trabalho multi-contas.
- AdsPower vs Hidemyacc: Comparação de Navegadores Anti-Detecção 2026 - Compare os navegadores anti-detecção AdsPower vs Hidemyacc. Recursos, automação, preços, segurança e qual se adequa ao seu fluxo de trabalho multi-contas.
- Revisão do Google Analytics 2026: Prós, Contras e Veredito Honestos - Uma revisão baseada em evidências do Google Analytics cobrindo usuários ideais, configuração, pontos fortes, limitações, preços e critérios de decisão para profissionais de marketing e proprietários de empresas.
FAQ
Posso executar vários perfis AdsPower simultaneamente com o Scrapy?
Sim. Inicie cada perfil com um user_id único e gerencie-os em paralelo usando a configuração CONCURRENT_REQUESTS do Scrapy.
Preciso de um plano pago do AdsPower para esta integração?
O nível gratuito inclui 2 ambientes de navegador, o que é suficiente para testes. Para scraping em produção com muitos perfis, considere um plano pago.
Como faço para rotacionar impressões digitais entre requisições?
Crie vários perfis AdsPower com impressões digitais diferentes. No seu spider, alterne entre valores de user_id para cada requisição.
Este método é detectável?
A falsificação de impressão digital do AdsPower reduz significativamente o risco de detecção, mas nenhum método é 100% indetectável. Sempre respeite o robots.txt e os termos de serviço.
Conclusão
Integrar o navegador de impressão digital AdsPower com o Scrapy cria uma configuração de scraping robusta que contorna a detecção de impressão digital do navegador e associação de contas. Usando a API Local do AdsPower para lançar ambientes de navegador isolados, seus spiders do Scrapy podem raspar dados furtivamente em escala.
Para mais sobre navegadores anti-detecção, confira nossa comparação AdsPower vs Undetectable. Se você é novo na automação com AdsPower, nosso guia sobre como usar o AdsPower com Python cobre o básico.
Comece com uma conta gratuita do AdsPower e um spider Scrapy simples. Teste em um site de baixo risco e depois aumente a escala conforme ganhar confiança.